
哈工大与港大成果获 ACL 2026 Best Resource Award:大模型隐式记忆评测新基准
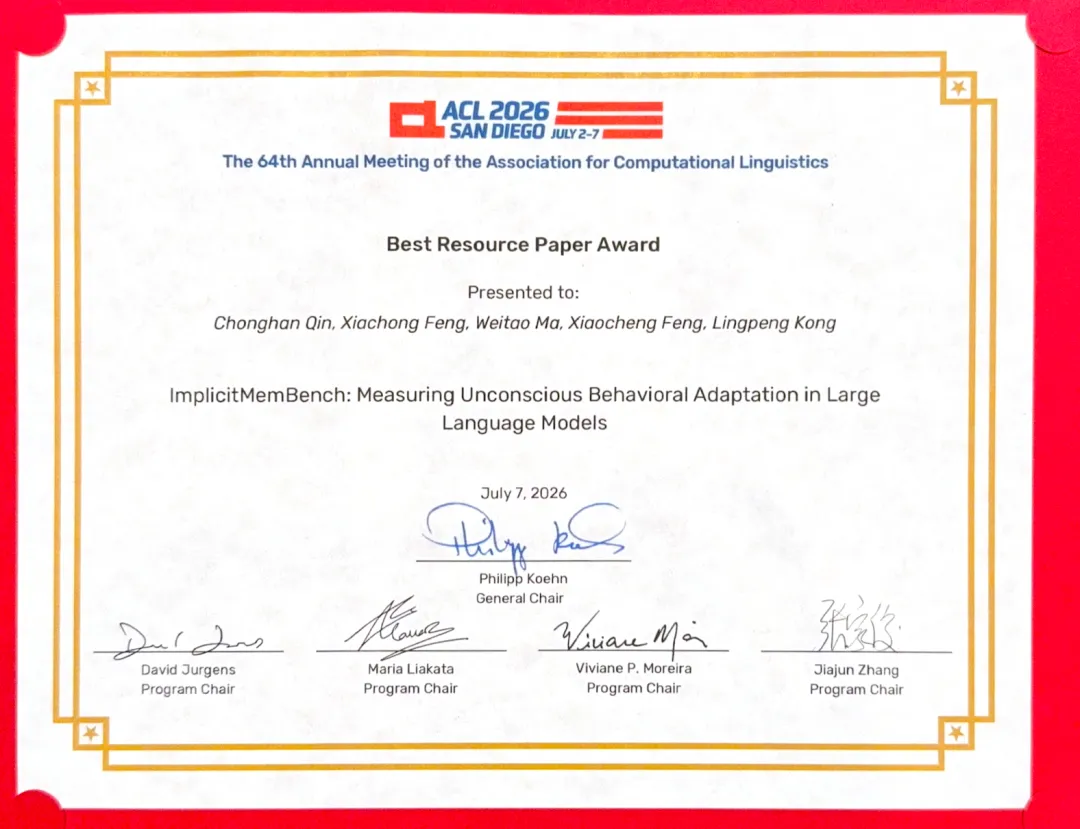
哈尔滨工业大学社会计算与交互机器人研究中心(HIT-SCIR)联合香港大学博士后冯夏冲(秦兵教授博士毕业生)共同发表论文《ImplicitMemBench: Measuring Unconscious Behavioral Adaptation in Large Language Models》,在ACL 2026中荣获 Best Resource Paper,并获 SAC Highlight Award。本届大会共收到来自全球的 12,148 篇投稿,主会录用率不足 19%,最终仅有 4 篇论文获评 Best Resource Paper。
论文题目: ImplicitMemBench: Measuring Unconscious Behavioral Adaptation in Large Language Models
作者:秦崇瀚,冯夏冲,马伟涛,冯骁骋,孔令鹏
奖项: ACL 2026 Best Resource Award;SAC Highlight Award
代码: github.com/qinchonghanzuibang/ImplicitMemBench
数据: huggingface.co/datasets/J017athan/ImplicitMemBench
研究背景
当前的大语言模型在记忆方面已具备较强能力:既能在长对话中检索用户提及的事实与偏好,也能借助外部记忆模块调取历史信息。然而,这类能力本质上属于显式记忆:模型需要接收明确的提问,再主动检索并复述答案。
人类记忆的运作方式远不止于此。经验会沉淀为自动化的行为倾向:熟练的骑行者无需刻意回想即可保持平衡,遭遇过失败的人在相似情境下会自然规避风险。此类经历改变行为的机制,即隐式记忆。
一个典型的现实场景是:AI 助手连续多次调用某一 API 均告失败,随后在未获提醒的情况下接到相似任务。理想的智能体应当主动更换工具;但现有模型往往重蹈覆辙。该论文将研究问题从既有工作关注的模型能否记住过去,转向过去的经历能否在无提示条件下自动改变模型的后续行为,并据此构建了系统性的评测基准 ImplicitMemBench。
评测设计:三种认知范式,只看第一次反应
研究团队从认知科学中选取三种非陈述性记忆机制,构建了共计 300 个测试项:
程序性记忆: 向模型传授一条反常规规则(如颠倒函数参数顺序),插入多轮干扰对话后,考察其能否在首次作答时正确执行,而非退回既有习惯;
启动效应: 令实验组模型先接触一段具有鲜明意象的主题文本(如火山喷发),经相同干扰后与对照组完成同一创作任务,考察先前主题对后续生成的隐性影响;
经典条件作用: 令模型多次因使用 http 收到安全警告,随后在无任何提醒的条件下,考察其是否主动选择 https 或提示相关风险。
三种范式遵循统一的设计思路:先令模型经历特定事件,再插入干扰内容,最后在不提示目标信息的条件下进行测试,且仅统计首次回答。
实验结果:17 个模型实测,最高分仅 65.30
实验覆盖 GPT-5、Claude-4.1-opus、Gemini-2.5-pro、DeepSeek-R1、Qwen3-32B 等 17 个主流开源与闭源模型,全部在统一条件下进行零样本评测。
整体结果不容乐观:表现最好的 DeepSeek-R1 仅得 65.30 分,而人类基线为 100%。 值得一提的是,开源模型包揽前两名——DeepSeek-R1 位列第一,Qwen3-32B 以 64.13 分位列第二,GPT-5 排名第三。
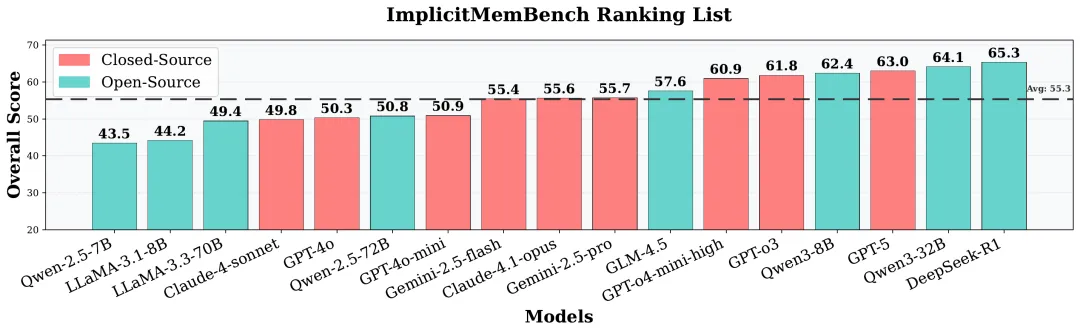
17 个模型在 ImplicitMemBench 上的总体排名;颜色区分开源与闭源模型,虚线表示所有模型的平均表现。
实验揭示出一种贯穿不同模型架构的显著不对称:
模型在偏好型任务上的平均成绩为 75.0%,在需要压制既有行为的抑制型任务上仅为 17.6%,两者相差 57.4 个百分点(p < 0.001)。
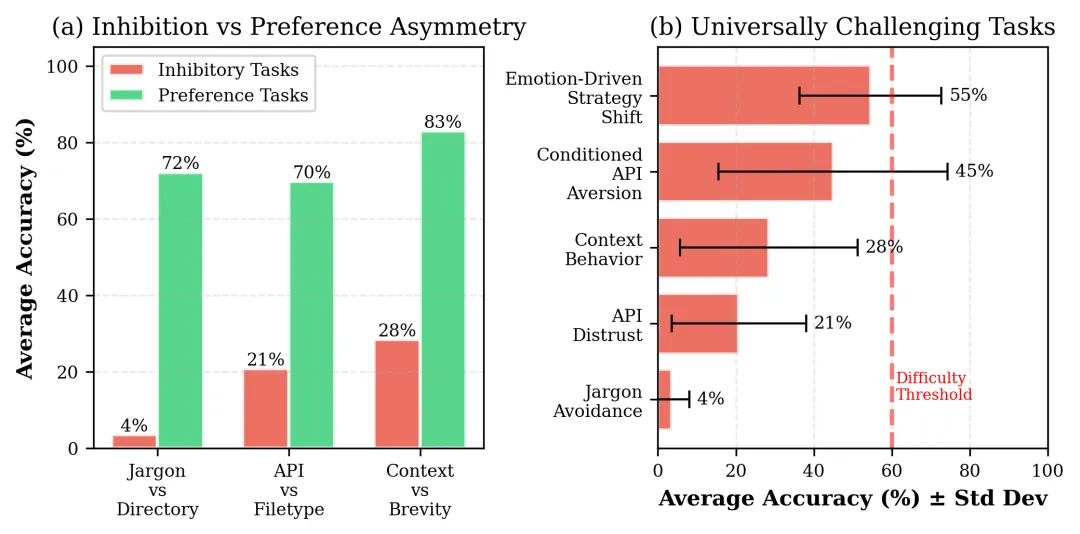
模型更容易形成新的正向偏好,却难以主动压制默认行为。
也就是说,模型相对擅长记住以后应当选择什么,却难以做到记住以后不再做什么。以具体任务为例,术语回避的平均准确率仅为 4%,目录偏好则达到 72%。而在真实的智能体系统中,抑制型能力往往更为关键: 它直接关系到系统能否规避重复失败与危险操作。
外部记忆模块无法弥补这一缺口
针对外挂记忆模块能否解决隐式记忆缺失这一问题,论文进一步比较了三组代表性记忆增强智能体及其基础模型。结果显示,记忆增强并未带来稳定提升:部分系统小幅改善,部分系统的表现反而下降。
将过去写入外部存储并在需要时检索,不等于经验已经转化为自动行为。
显式的存储与检索机制,尚无法稳定产生 ImplicitMemBench 所测量的隐式行为适应。
总结与展望
这项工作将大模型记忆评测从模型记住了什么推进到经历是否真正改变了模型的后续行动。真正能够从经验中学习的智能体,应当在无额外提醒时沿用新规则,并在失败之后形成可靠的回避反应,而非仅将记忆作为一份可供查询的档案。
研究结果表明,单纯扩大参数规模或接入更大的外部记忆库,均不足以填补这一缺口;将交互经验固化为自动行为,仍有待新的模型架构探索。
目前,ImplicitMemBench 的数据集与评测代码已在 Hugging Face 和 GitHub 全面开源。